全国产语音基座大模型落地,讯飞星火Spark-Audio-1.0-Preview正式发布
时间:2026-09-17来源:互联网作者:down
科大讯飞正式上线Spark-Audio-1.0-Preview,这是一款基于全国产算力训l练的语音基座大模型。
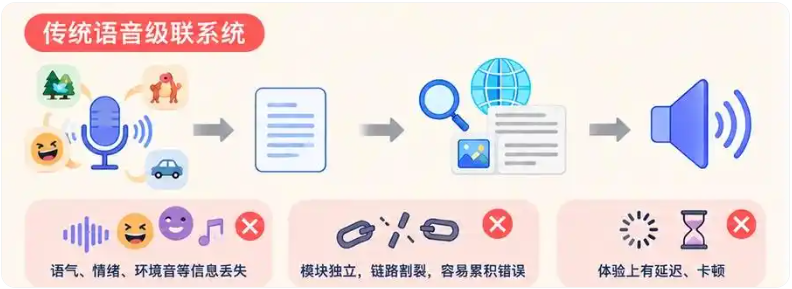
此前音频大模型普遍采用级联方案,先将语音转成文字再交由模型理解,存在两处明显短板:一是信息丢失,会遗漏语气、情绪、环境音等
关键信息;二是链路割裂,多模块串联运行易累积错误,还会出现延迟卡顿。
这款语音基座大模型可直接理解语音,一次性识别人声、环境音、音乐等内容,同时读懂语义、情绪与场景,解决了传统方案的痛点。
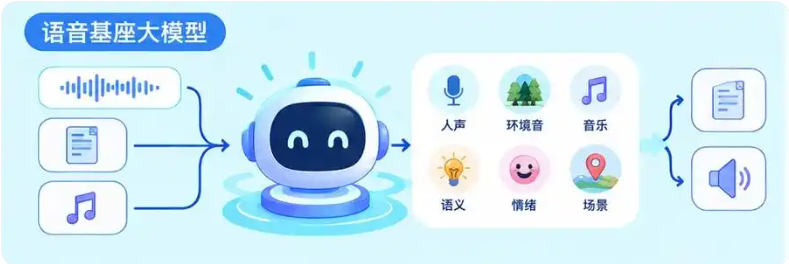
Spark-Audio-1.0-Preview是地道的国产语音基座大模型,采用0.65B音频编码器搭配30B-A3B大语言模型,基于1300万小时音频与海量文本数据,通过纯国产算力集群训练完成。它支持音文双模态输入,可完成语音转写、多语言翻译等多项任务,覆盖99种语言与202种方言,推动机器从“听清”走向“听懂”。该模型多项评测表现亮眼,复杂场景优势明显,通用能力无明显降智,后续将巩固优势、补齐短板。
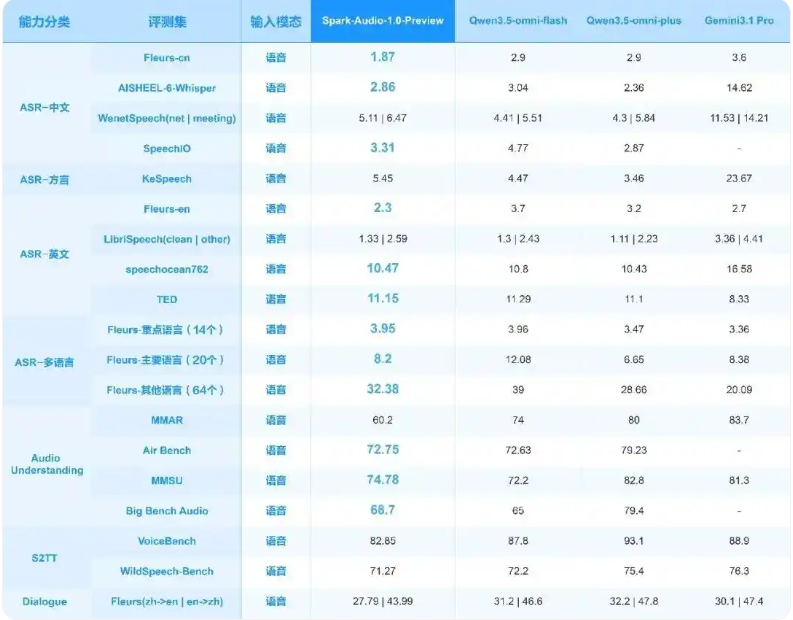
音频公开测试集
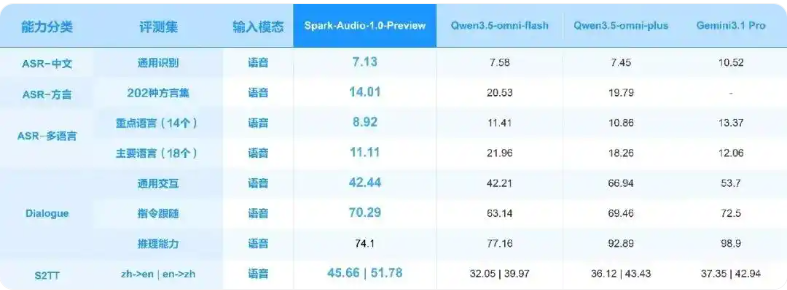
自建音频测试集
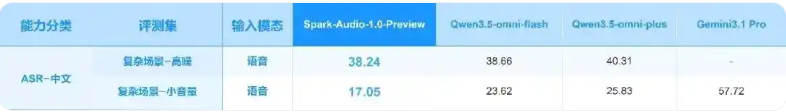
复杂场景自建音频测试集
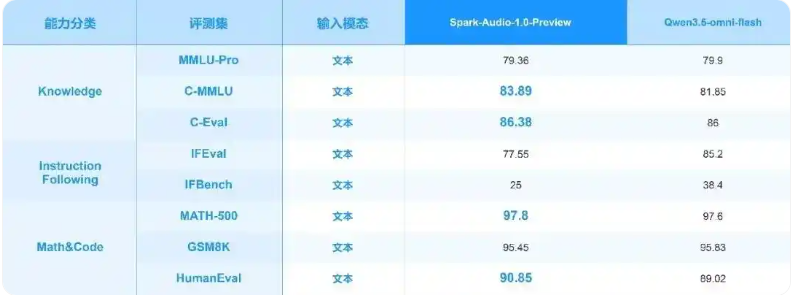
文本公开测试集
注:ASR语音识别相关任务以WER、CER为评价指标,数值越低表现越好;S2TT语音翻译任务采用BLEU分作为评价指标;其余任务均使用准确率指标,数值越高表现越好。
目前Spark-Audio-1.0-Preview已正式开放体验,相关API后续将上线讯飞开放平台。
热门推荐
-
WPS Office
版本:官方最新版12.1.0.28505大小:231.00MB
WPS Office ppt官方版是WPS Office的一个组件,用于设计制作专家报告、教师授课、产品演示、广告宣传的电子版幻灯片,制作的演示文稿可以通过计算机屏幕或投影机播放。本次提供WPS Office完整版下载,其中的组件WPS Office ppt官方版可播放MS-PowerPoint97~2003系统所制作的PPT文件。
查看
-
微软Office2007
版本:4.3.5.10大小:5.69MB
Office 2007全免费版是微软Office产品史上最具创新与革命性的一个版本。全新设计的用户界面、稳定安全的文件格式、无缝高效的沟通协作。
查看
-
XMind8
版本:官方中文版大小:158.00MB
xmind8官方中文版是一款非常流行且老牌的免费思维导图制作与编辑软件。xmind8官方中文版是风靡全球的头脑风暴和思维导图软件,能跨平台支持支持 Win、Mac、Linux 和 iOS,xmind8官方中文版还能制作流程图、鱼骨图、逻辑图等,帮助用户快速捕捉创意与灵感。
查看
-
MindManager
版本:v2019大小:202.53MB
mindmanager中文破解版是一个可视化的工具,可以用在脑力风暴和计划当中。提供给商务人士一个更有效的、电子化的手段来进行捕捉、组织和联系信息和想法。作为便笺,挂图和白板的数字化替代品,mindmanager中文破解版提供更快的理解、更好的判断和减少会议时间来提高工作效率。
查看
-
excel2007官方版
版本:4.3.5.10大小:5.69MB
excel2007官方版是由微软公司开发的系列办公软件Microsoft office的组件之一;excel2007官方版可以满足用户在电脑上进行电子表格编辑,附带操作多种工具和应用公式;excel2007官方版市场占有率极大,大部分的计算机用户都会使用Excel来进行办公。
查看