阿里千问QwenGyre发布:面向长时序智能体任务的端到端在线RL框架
时间:2026-10-14来源:互联网作者:dingding
阿里千问正式发布面向长程智能体任务的在线强化学习框架QwenGyre。针对复杂工作场景下智能体数小时连续执行、数百轮环境交互、累计处理百万级Token的训练难题,该框架通过弹性调度与轨迹处理能力,将超长程任务转化为有效训练来源,同步实现智能体能力与训练效率的双重提升。
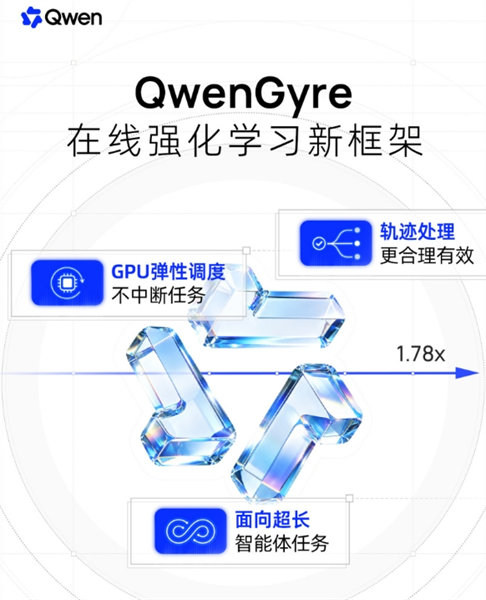
QwenGyre可将GPU划分为多个独立计算单元,采用“任务完成一批、空出单元即刻转入训练”的流水式调度逻辑:未结束的长程任务全程不受干扰,原有执行进度、状态与计算缓存完整保留无需重跑;新释放的计算单元直接接入当前训练流程,算力资源按需动态分配,最终由核心单元汇总完成参数更新,实现长程智能体任务执行与强化学习训练的高效并行。
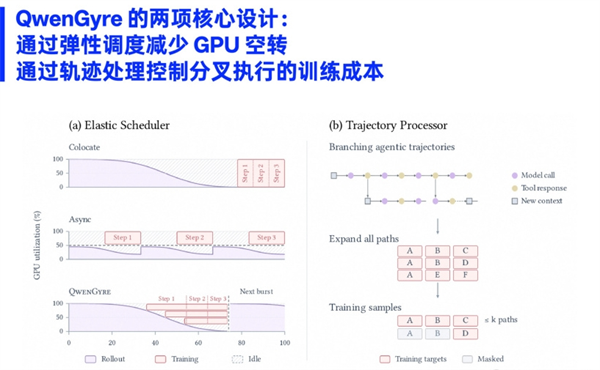
QwenGyre通过Token-in Token-out机制完整记录每段模型输出生成时的真实上下文,按共享前缀将交互轨迹组织为轨迹树,仅将目标选中的有效路径展开为训练样本。同时,框架支持通过Partial Scoring对超时但已完成部分执行的任务生成有效反馈,避免长程智能体执行过程中产生的中间交互数据被浪费。
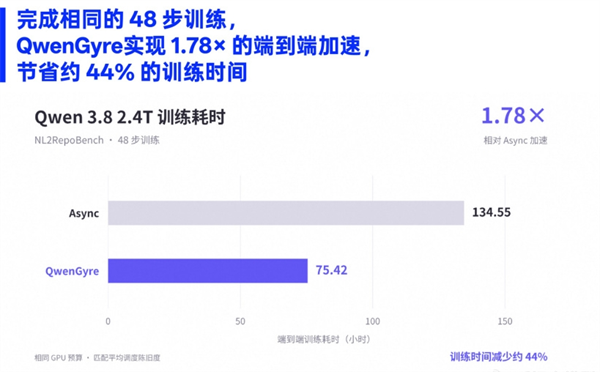
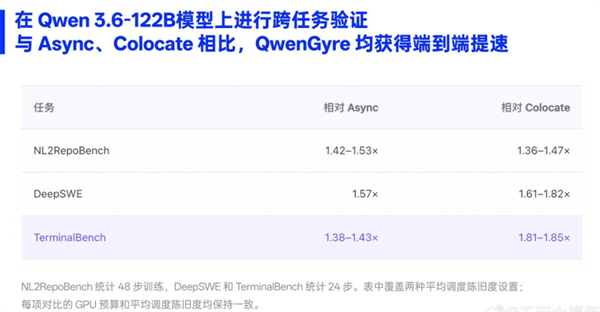
在跑分方面,阿里千问官方在NL2RepoBench在线强化学习实验中,以单轮约70万token的长程任务开展训练,48步训练后模型通过率从52.5%提升至58.5%。同等GPU预算下,QwenGyre较Async实现1.78倍端到端加速,训练效果与Async、Colocate方案持平;在Qwen3.6-122B上的跨任务验证中,NL2RepoBench、DeepSWE、TerminalBench三类长程智能体任务均实现端到端提速。
热门推荐
-
WorkBuddy
版本:官方版5.7.7大小:415.77MB
WorkBuddy官方版是一款由腾讯云 CodeBuddy 团队推出的全场景AI智能体桌面工作台。WorkBuddy软件功能强大、操作简单,内置有DeepSeek、GLM、Kimi等多种 AI 模型,支持同时发起和管理多个任务,统一看板实时查看进度。WorkBuddy软件主打自然语言驱动办公自动化,用户只需用一句话描述需求,AI 自动拆解任务、规划步骤、调用工具完成交付。
查看
-
百度搭子DuMate
版本:1.0.83大小:702.92MB
百度搭子DuMate官方版是一款功能强大、专业实用的企业级桌面 AI 办公智能体软件。百度搭子DuMate软件集成了多种自动化任务管理工具,支持一键完成文件智能管理、多源数据分析、办公操作自动化等任务。百度搭子DuMate软件采用了本地安全沙箱运行模式,所有数据、文件及操作行为均在用户本地设备内隔离流转,能够有效避免用户数据泄露的风险。
查看
-
豆包工作
版本:官方版v2.25.16大小:3.64MB
豆包工作官方版是一款功能强大、专业实用的AI智能助手桌面客户端,专为办公场景深度设计。豆包工作最新版软件将AI能力从网页对话框延伸到整个桌面工作流,既能回答你的问题,也能在授权后帮你动手处理本地任务。从制作 PPT、处理文档表格,到定时任务、自动整理文件,豆包工作统统能够帮你轻松完成。
查看
-
WPS Office
版本:官方最新版12.1.0.28505大小:231.00MB
WPS Office ppt官方版是WPS Office的一个组件,用于设计制作专家报告、教师授课、产品演示、广告宣传的电子版幻灯片,制作的演示文稿可以通过计算机屏幕或投影机播放。本次提供WPS Office完整版下载,其中的组件WPS Office ppt官方版可播放MS-PowerPoint97~2003系统所制作的PPT文件。
查看
-
微软Office2007
版本:4.3.5.10大小:5.69MB
Office 2007全免费版是微软Office产品史上最具创新与革命性的一个版本。全新设计的用户界面、稳定安全的文件格式、无缝高效的沟通协作。
查看